开源范围:
支持模型:DeepSeek-V4.1-Flash
支持硬件:NVIDIA SM100(Blackwell)和华为昇腾 950
- 其他厂商要用deepinfer,就要让自家芯片满足deepinfer要求,要么用tilelang写,让deepinfer的算子通过tilelang后端编译到芯片上,要么就厂商自己实现那些算子
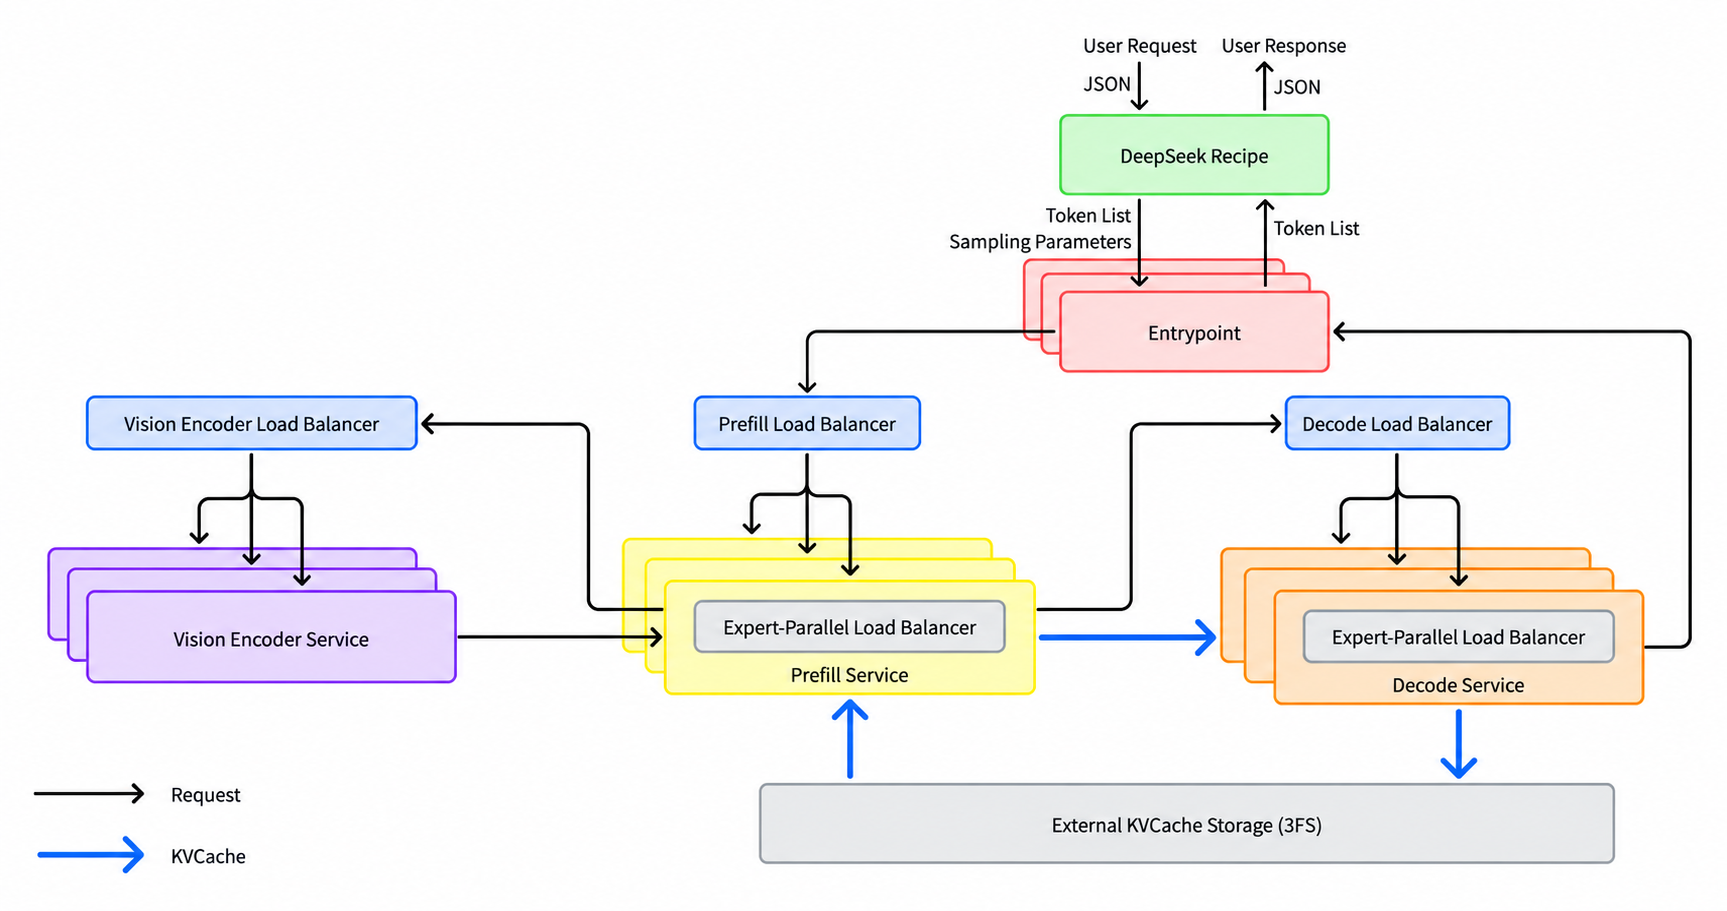
只包含离线推理;KV cache 存储系统、PD 分离、负载均衡和在线服务还未开源。目前更接近推理系统里单个推理引擎实例的部分,不算得上是服务框架
DeepInfer 里最省钱的部分,都和 DeepSeek 的模型结构绑在一起,要求训练时就按这种方式设计模型
- 跨层共享 KV
- YOCO(You Only Cache Once)….
SM80/SM86、SM90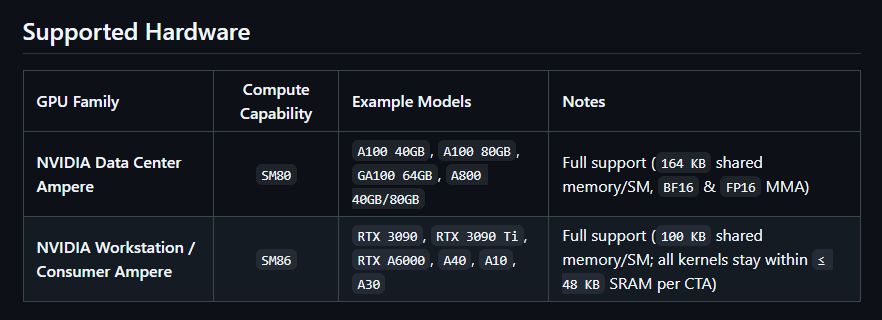
| 指标 | 基线 vLLM | Deepinfer-SM80 | 差异 |
|---|---|---|---|
| 16K Prefill 吞吐 | 3,349.4 tok/s | 4,037.0 tok/s | +20.5% |
| 64K Prefill 吞吐 | 3,627.3 tok/s | 4,506.8 tok/s | +24.2% |
| 64K TTFT | 13.2 s | 10.7 s | -18.9% |
| 4 并发 Decode 吞吐 | 163.8 tok/s | 170.5 tok/s | +4.1% |
| 单请求代码 Decode | 151.8 tok/s | 160.8 tok/s | +5.9% |
1 负载均衡
1.1 Prefill Load Balancer
目的:把 Prefill 请求分配给不同 GPU,并动态决定每张 GPU 一次处理多少 Token,避免多张GPU负载不均衡
三个变量:
q,序列中未命中的token数,本次需要计算的新token数c,这条序列已经算完的前缀长度cost(q,c):预计处理这些新token需要的计算量(记为compute-quota)
整体分为四层:
(1)分桶,按输入总长分为4档:<16K / 16-64K / 64-256K / ≥256K,每档分配到的引擎台数,按该档上一轮compute-quota的需求占比,动态重新分配每个桶能够使用多少引擎
(2)DP组间调度,查看各组剩余的compute-quota,把新请求分配给仍有较多计算余量的组,由于任何引擎都能命中任何前缀,不做前缀亲和路由
(3)DP组内调度,一批请求给到引擎后,每收到一个,就分发到当前 compute-quota 负载最低的 DP rank
(4)单卡内调度,每步有一个时间预算(单位是纳秒),调度时用拟合的二次代价模型 cost(q, c) 预测这一步要花多久,对 q 反解这个二次方程,取正好满足剩余时间预算的最大q,即反过来求出在预算内最多能处理多少新 Token
1.2 Decode Load Balancer
目的:同时均衡请求数和 KVCache 总长度两个维度,前者决定每步batch大小,后者决定注意力部分的代价
Decode Load Balancer对所有decode实例的所有卡进行统一路由,启发式地将短请求发给并发较小且 KVCache 总长偏大的卡,长请求发给 KVCache 总长较小的卡
1.3 Vision Encoder Load Balancer
对于图片的路由以单台机器为单位,由 prefill 机器随机选中一台部署有卡数个 vision encoder 的机器,在这台机器上,将图片交由当前处理图片 patch 数目(由宽高直接算出,(width/patch_size) × (height/patch_size))最少的卡的处理生成 embedding。
1.4 Expert-Parallel Load Balancer
目的:解决MoE 模型中,有些专家特别热门,大量 Token 都需要它们,导致部分 GPU 很忙,而其他 GPU 相对空闲的问题
每卡在常驻专家之外多备若干冗余专家,用来放热门专家的副本。通过统计最近 N 步各专家的负载,每 M 步根据统计结果重新分配专家到卡实现动态调整,其中专家权重在 scale-up network 里经 symm_mem 在并行组内转移。
| 项目 | Prefill | Decode |
|---|---|---|
| 初始冗余专家 | 每卡 4 个 | 每卡 1 个 |
| 统计窗口 | 100 步 | 1000 步 |
| 重新分配周期 | 每 1000 步 | 每 10000 步 |
| 主要特点 | 更频繁地观察较短周期内的负载变化 | 统计窗口和重排周期更长 |
prefill $moe_lb=\dfrac{最慢rank的负载}{所有rank的平均负载}=1.0320(EP2/DP2)、1.0618(EP4/DP4)$
decode $moe_lb=1.090$

2 自动扩缩容
目的:PD 分离后两者的资源需求比例随流量动态发生变化,静态配比下的资源错配导致排队和空转的发生,因此需要通过自动扩缩容在集群层面跟随流量调整 Prefill/Decode 实例的比例。
实现方式:Prefill 通过统计未命中 token 数判断所需实例数目,decode 通过在计算的请求数判断所需实例数目,调整有限速和上下界。其中,针对大 EP 部署时长尾请求导致资源浪费的问题,decode 实例收到下线通知后进入宽限期(1 min),宽限期结束后仍未完成的请求及其 KVCache 一次性全部转发给其他实例继续 decode 计算
冗余配额:提前准备额外的计算容量,避免流量突然增加时来不及扩容。两种做法,一是池子里留有尚未被占用的 ready 机器作为扩容库存。二是实际在线实例数略高于计算出的最低需求。配额占用率高于 80% 时禁止缩容,以免随后流量反弹造成容量不足
容错机制:不依赖快速重启来解决故障,而是通过冗余容量和请求重新路由来恢复服务
3 KV Cache
DeepSeek-V4.1-Flash 模型的 KVCache 存储分为两个部分:Block KVCache 和 State KVCache,分别存储于 3FS 集群和本机内存中。
Block KVCache 解决怎样让大量请求跨机器复用历史计算结果,SWA KVCache 解决怎样低成本保留近期滑动窗口状态,并支持投机解码回退
3.1 Block KVCache
以 128 tokens 为一个 block 进行分页式管理,根据模型架构设计,存储 4 层的 main KV 和 indexer K,运行中的保存在GPU显存中,分页的存在3FS中
- 将可复用的 KV Cache 保存到 3FS,让不同机器上的 Prefill 实例都能复用,而不是只依赖某台机器的本地缓存,不必为了命中本地缓存而强制把请求路由到某台机器,也更容易动态扩缩容
- 设计考虑:扩大存储容量来提升命中率,提升带宽来降低读取延时
- 如何命中缓存并让数据进入GPU:匹配前缀,找到可复用block→从3FS读取到共享内存→通过GDR/RDMA传输到GPU
- 由于 CUDA copy engine 对于(大量分散的)KVCache Block 细粒度的拷贝性能不佳,换入使用 GDR 实现,用 RDMA 网卡就能打满 PCIe 带宽,并且不占 SM
3.2 SWA KVCache

前 20 层各一个 134 token 的 ring buffer(窗口长度=128 + 投机回退=6),额外的 6 个位置用于吸收投机解码回退造成的边界偏移,不存储压缩中间态,保存在产生它的 Prefill/Decode 机器的内存。只在 128 tokens 的整数倍位置上存储
- Prefill阶段,chunked prefill 中途不存储,只存储最后一个chunk,在位置取序列末尾留出一个 token 后向下对齐到 128 所得的位置 $P=\left\lfloor\frac{L-1}{128}\right\rfloor\times128$
- Decode阶段,在显存中另开一块副本区,每跨过一个 128 tokens 边界就把该请求当前的窗口在显存内拷入副本区(0~128、129~256….),请求结束时,再保存最近一次完成的有效边界对应的窗口
3.3 命中策略
- Block KVCache:决定命中长度
- SWA KVCache:决定最后一个 block 是否需要重算
对于输入长度L,最大的命中长度最多为 L - 134,134是SWA窗口+6token投机回退。
对于Block KVCache:得到命中长度L1,L1必须为128整数倍,且L1 ≤ L - 134
对于SWA KVCache:检查L1-128至L1长度范围内(也就是L1最后一个大小为128的block),如果对应的SWA KVCache状态存在,则命中长度为L1,反之命中长度为L1-128,最后一个block(大小为128的窗口)需要重算
3.4 SWA Bounded Replay
SWA KVCache在未命中时重算层数 × 窗口个 token 做完整前向,逐层精确恢复窗口状态。这条路径代价很高,必须用足够大的 SSD 容量把未命中率压到极低,代价是 SWA KVCache 占去持久 KVCache 近一半容量,且未能带来相应的命中收益。
目的:当 SWA KVCache 缺失时,DeepSeek 不再花大量成本精确恢复整段历史状态(20×128),而是只重算最近 128 个 Token,构造一份近似的 SWA KVCache,降低跨层状态恢复成本。
把注意力窗口截断在重算段内:从位置 s 起回放,位置 i 的 query 只和 max(s, i − 127) 到 i 区间的 key 计算($j \in[max(1, i-W+1),i]$,这里W=128),重算得到近似的 SWA KVCache。重算代价由此降为与上下文长度和层数无关的常数。该机制用在两处:
Encoder SWA Bounded Replay:
Block KVCache 原样复用、不重算不覆写,SWA KVCache 缺失时,重算命中前缀的最后 128 个 token,与未命中后缀一同前向
比如有8500token的prompt,前8192个token在block kv cache命中、后308个没有命中(没缓存)、第8192的SWA miss、SWA窗口大小128。此时需要replay8065~8192计算SWA KV(细节:8065只能关注8065,8066关注8065~8066…..),但是复用已有block KV,未命中后缀从8193开始,新后缀(8193~8500)利用这些SWA KVcache
Decoder SWA Bounded Replay:
CED 架构下 decoder 层的 Block KVCache 由 encoder 末层 hidden state 投影得到,仅 decoder SWA KVCache 需各层自算,精确重建要 20 个 decoder 层跑最后 2560个 token(20x128,逐层追溯),Bounded Replay 则只重算 Prompt 最后的 128 个 Token,每层SWA的注意力窗口依旧是128token,只是重新计算的历史序列范围变小了。
4 DeepSeek Recipe
4.1 API 多协议适配
部署失败不一定是模型没跑起来,也可能是 API 的输入输出行为不兼容。对于同一个模型,如果不同推理框架采用了不同的 Prompt 模板,或者对工具调用 Token 的解析不一致,即使底层模型权重完全相同,实际行为也可能不同。
deepseek recip将Chat Completions、Responses、Messages的API请求转成同一种对话格式,共用模型模板和编码逻辑,按模型版本生成 prompt 和 token 序列
- Rust实现请求转换、prompt 编码和输出解析
- pythin binding让 Python 推理框架和应用可以直接调用 Rust 实现
4.2 Tokenizer 处理与加速
tokenizer两个问题:上下文越来越长,线性tokenize影响TTFT;special token被用户作为普通文本输入,但是被tokenizer识别为special token
deepseek receipe的处理方法:
- 输入编码
- 框架真正插入的特殊 Token:记录它的位置,直接映射到专用 Token ID
- 用户输入中的同名字符串:当作普通文本编码,转换成普通 Token 序列。
- 输出解析
- 检查生成的token ID是否属于special token(输入时就决定了),模型用普通 token 拼出的相同文本会被正确保留为原始内容,不会获得 special token 触发思考结束或工具调用的能力
<\think>、|DSML|deepseek markup language,是用于表达工具调用的格式
- 输入编码解决的是“不要把普通文本当成控制标记”;输出解析解决的是“不要把普通文本误判为控制事件”
- 分段加速:
- 传统处理会把整段prompt交给tokenizer编码
- deepseek recipe则可以利用已知的special token的位置和边界,跳过编码时它们的匹配和切分,将普通文本分成多个片段,分别独立编码各段普通文本,并行编码,最后再把特殊 Token ID 和普通文本的 Token ID 按原顺序拼接,降低编码延迟,改善TTFT
4.3 流式输出解析
推理后端按 token 粒度返回 chunk,一个 UTF-8 码点、DSML 标签或工具调用参数都可能被拆分到多个 chunk 中。
目的:正确得到decode输出,尽早解析结构来处理和输出已经确定的内容
- 跨chunk解析:解码遇到不完整的UTF-8码点时,先缓冲相关 token,待后续 token 到达、能够补齐状态后,再交给解析器;已确定的内容则随解析进度输出,无需反复扫描此前的文本
- 解析器按思考、正文和工具参数等阶段维护状态,使用 KMP 算法增量地匹配分隔标记,用来记住目前匹配到哪里
- 比如“你”在UTF-8 编码中通常占 3 个字节,chunk1前两个字节,chunk2最后一个字节。先暂存不完整的字节,等下一个chunk到达后补齐再解码
- 工具参数转换:工具名解析完成后即可返回,后续根据 DSML 参数边界直接生成 JSON 片段。识别到参数边界后,尽可能逐段处理和输出已经确定的内容。字符串值逐段做 JSON 转义,数组、对象等非字符串值按原始 JSON 文本输出,无需构造完整参数对象,省去反复解析和序列化的开销。即使参数较长,也可以在生成过程中逐段返回,缩短首个参数片段的等待时间
- 完整参数对象 ,识别到
{"query":"DeepSeek 最新论文"时就可以输出{"query":"DeepSeek 最新论文","limit":10}
- 完整参数对象 ,识别到
5 异步调度
Decode 第 N 步流程为:schedule(N) → forward(N) → sample(N) → post-process(N)
schedule(N)决定本轮处理哪些请求forward(N)执行模型前向计算sample(N)采样得到下一个 Tokenpost-process(N)更新请求状态、处理生成结果
GPU 明明已经完成计算,却要停下来等 CPU 整理上一轮生成结果、更新请求状态,再安排下一轮工作。于是deepinfer让 CPU 提前一轮安排计算CPU:schedule(N) → 等待GPU同步sample(N)结果 → post-process(N) → launch_sample(N+1) GPU:forward(N) → sample(N) → GPU等CPUlaunch_forward(N+1),把原本串行执行的调度和模型前向重叠起来,但是在下一轮计算启动时forward(N+1),上一轮的 Token 可能还没完成 CPU 后处理post-process(N-1),序列长度、KV Cache 状态和请求生命周期便会出现时间差
参考已有实现:
CPU:schedule(N+1) → launch_forward(N+1) → post-process(N-1) → launch_sample(N+1)
GPU:forward(N)    → sample(N)           → forward(N+1)      → sample(N+1)
这套方法的收益取决于 CPU 工作与 GPU 计算能够重叠多少。当 CPU 处理时间超过设备计算能够覆盖的窗口时,仍然会出现等待,因此 Zero-Overhead 更接近一种执行调度目标。
Dspark
DSpark 通过 Confidence Head 预测每个 draft token 的接受率,调度时把验证算力分配给边际收益最高的 token。CPU 负责决定下一轮总共能验证多少 Token;GPU 根据最新 Confidence 决定每个请求具体验证几个 Token,验证方法是做重算(累乘、全局排序取 top-k,并融合 remap scatter),结果写回pinned buffer,供GPU后续处理
schedule(N+1)时确定预算,假设此时有两个请求A、B,每个请求的draft都生成5个候选token,但是CPU只允许验证6个(固定长度验证会浪费验证算力在低概率 token 上,所以做变长验证)- GPU正在执行第N步,先获得confidence head的预测,做累乘、topk(6)、remap(10→6)
- 累乘:投机解码必须从前往后连续接受 Token
- topk:从10个token选出概率最高的6个
- remap:根据选择结果整理验证数据与索引
开启推测解码后,一条请求可能连续接受多个候选,不同序列的实际推进长度也会出现差异
- 容量预留
- 两轮 Batch 中请求位置不一致的问题:请求可能结束、加入或被抢占,同一条序列在不同 Batch 中的排列位置也可能改变。DeepInfer 因此通过 Remap 映射,将当前轮的请求对应到上一轮保存的执行状态,新加入的请求则使用特殊标记。
相比vLLM
(10-21)
所有测试点的输出吞吐差异都在约 ±6% 以内(This is because vLLM has continuously integrated DeepSeek’s kernel libraries (MegaAttn, MegaMoE, Mega-mHC, etc),vLLM 持续集成了 DeepSeek 的内核库)
| 项目 | vLLM | DeepInfer |
|---|---|---|
| 模型 | DeepSeek-V4.1-Flash | DeepSeek-V4.1-Flash |
| GPU | 32 × GB200 | EP64DP64,64 GPU |
| 并行配置 | DEP32 | EP64DP64 |
| 上下文长度 | 131K | 131K |
| 投机解码 | DSpark,3 个 Draft Token | 按对照曲线设置 |
| 平均接受 Token 数 | 固定按 3.25 Token/Step 对齐 | 3.25 Token/Step |
| 冗余专家 | 32 个 | 64 个 |
| EPLB | 开启 | 使用专家负载均衡 |
| 测试范围 | Batch Size 8~256 | Batch Size 8~256 |
vLLM 已经针对 DeepSeek V4.1 实现了 SWA Bounded Replay,并且支持相应的 Decoder CUDA Graph 优化,实现约 30% 的 TTFT 减少;低并发性能提升1.9x,在150TPS约束下吞吐量提升5.3x(2026-10-07)ds4.1flash+vLLM
复用:
- prefill调度
vLLM
- 用
--max-num-batched-tokens限制单次调度的 Token 预算
- 支持 Chunked Prefill,但是相同数量的 Prefill Token,在已有上下文长度不同时,计算耗时可能不同
DeepInfer - 根据预测耗时
cost(q,c)动态决定 Chunk 大小,在剩余时间预算内,计算还能处理多少 Token。更稳定地控制 Prefill 执行时间、TTFT 和 Decode 干扰,尤其适合混合长短上下文请求
可复用点:在 vLLM Scheduler 中引入 Cost-aware Chunked Prefill,根据预测执行耗时而非仅根据 Token 数量决定 Chunk 大小,改善长短上下文混合负载下的 TTFT 和调度稳定性
- decode调度
vLLM
- 对于新请求,主要参考各rank的running queue、waiting queue和未完成请求数量进行分配,主要看请求数量
- 也考虑 KVCache 使用率,当某个 Engine 存在等待请求且 KV 使用率较高时,会增加该 Engine 的负载惩罚。未直接将运行中请求的 KV 总长度纳入 Decode 工作量评分(DeepInfer)
DeepInfer - 同时考虑请求数和 KVCache 总长度两个维度,对所有decode实例的所有卡进行统一路由,启发式地将短请求发给并发较小且 KVCache 总长偏大的卡,长请求发给 KVCache 总长较小的卡,避免分配失衡
可复用点:二者做负载均衡的依据不同,可以在 vLLM 中增加总 KV 长度或预测 Attention 耗时指标,构建请求数量与 KV 负载联合评分函数,优化长短上下文混合请求的 Decode 吞吐和 TPOT
- KV Cache存储
vLLM
- 通过 LMCache 等组件实现 CPU、磁盘卸载和跨实例共享
- vLLM 的 DeepSeek V4.1 实现可以仅缓存 Global KVGlobal KV 命中,Prefix Cache 命中时,不保存可供后续请求复用的 SWA KV,需要通过 Encoder SWA Bounded Replay 恢复未缓存的 SWA 状态;Decoder SWA Replay 则不依赖 Prefix Cache 命中
DeepInfer - 并不是所有 KVCache 都使用同一种存储方式,对部分 SWA 状态采用主机内存保存
- 对于DeepSeek V4.1,仅保存前 20 层需要跨请求复用的 SWA 状态,并按 128 Token 边界保存
- SWA 状态缺失时采用 Bounded Replay 恢复,避免精确重算长历史
可复用点:二者在 KVCache 存储、跨机器复用及 Encoder SWA 缓存策略上存在差异,vLLM不保存可复用的SWA KV,而在Global KV命中后,对末尾128token执行Encoder SWA Replay,DeepInfer会考虑SWA状态是否命中,不一定做Encoder Replay。可测试的点:对比读取SWA状态耗时 和 Replay128token耗时,需要考虑缓存占用、命中率和跨机器传输开销
- MoE EP规模
deepinfer在prefill时EP2~8/DP2~8;、decode时EP64~128/DP64~128 (Wide-EP);vLLM默认EP=TP×DP
- 小EP,聚集更多 Token,提高 GEMM 效率。
- 大EP,把专家分布到更多 GPU 上,从而减少每张 GPU 在单步 Decode 中需要承担的专家权重读取量
vLLM通过PD分离为
EPLB,二者调整周期和统计窗口不一样