1 整体结论
两套框架采用的主线相同:先利用模型结构减少计算和状态,再用融合内核缩短执行链,最后处理分布式通信、负载不均和服务调度问题。
- vLLM 的突出工作是规模化服务。 Prefill 使用较小的 DEP 实例,Decode 使用 Wide-EP 与 EPLB;进一步优化 P/D 传输、CPU 同步和请求接入;低并发另外使用专用 Decode 路径。vLLM优化报告
- SGLang 的突出工作是完整集成及执行衔接。 接入 Mega 系列内核、DSpark、SWA bounded replay,优化 Engram 放置、内核之间的数据格式和可拆分 CUDA Graph,同时提供缓存、P/D 分离和路由服务。SGLang优化报告
_注意:两者各自与 DeepInfer 比较,硬件、并行规模、负载及统计口径并不相同_
2 模型特性决定优化方向
| 模型特性 | 特性说明 |
|---|---|
| CED 因果编码器—解码器 | 40 层分为 20 层因果 Encoder 和 20 层 Decoder;Decoder 的全局 KV 由 Encoder 最终隐状态投影得到。Prefill/Decode 每 Token 激活参数约为 8B/16B。 |
| CSA2 压缩稀疏注意力 | 设置 Full、Reindex、Reuse 三类层模式,结合 KV 压缩、跨层共享与稀疏索引复用;Decoder 的分层索引器在已有候选池内进一步筛选位置。 |
| 跨层共享与 FP4 全局 KV | 多层复用来源层生成的全局 KV;主 KV 使用 FP4 E2M1,每 16 通道共享一个 E4M3 缩放因子,全局 KV 约为 890 bytes/token。 |
| SWA 滑动窗口注意力 | 各层保留最近 128 个位置的局部 KV,由本层隐状态生成;这部分状态不跨层共享,与压缩的全局 KV 配合使用。 |
| SWA Bounded Replay 有界重放 | 只重放最近窗口内的 Token 来恢复缺失的 SWA 状态,并限制后段 Decoder 的 Prefill 范围;与完整计算不保证数值等价。 |
| 稀疏 MoE 与低精度权重 | 每个 MoE 层包含 384 个路由专家和 1 个共享专家,每 Token 选择 6 个路由专家;稠密权重采用 FP8,路由专家权重采用 FP4。 |
| Engram 条件记忆 | 通过 Token n-gram 哈希查询记忆表,将检索结果注入隐状态;记忆参数按输入条件稀疏访问。 |
| Single-Pass mHC | 调整多路残差的混合依赖,便于融合相关操作,减少重复显存读写与计算等待。 |
| DSpark 推测解码 | 草稿模型快速提出多个候选 Token,由主模型批量验证,减少生成过程中的主模型执行轮数。 |
3 vLLM优化策略
3.1 利用 CED 和跨层 KV 共享,减少 Prefill 工作
优化包含两个不同目的:
- Encoder 侧恢复窗口状态: 前缀命中后,重算命中边界之前的短尾部,恢复缺失的 SWA KV,减少需要长期保存的窗口缓存。
- Decoder 侧裁剪输入: 负责提供全局 KV 的层仍处理完整输入;后续复用这些 KV 的层,只处理请求末尾的128个Token(更新hidden state)。
- 查询远处历史,使用已经保存的全局 KV
- 查询各层的局部窗口,只需要输入末尾的 SWA KV
后续优化进一步裁剪 layer 20:完整写入所有新 Token 的 globalKV,但只对末尾 128 Token 做索引和注意力等剩余计算;layers 21–39 只运行这段尾部。裁剪后,前段完整批量与后段小批量形状不同;后段计算又很短,启动开销容易超过节省的 GPU 时间。因此 vLLM 使用可拆分的 PIECEWISE CUDA Graph,分别覆盖两部分。减少算量和降低启动开销需要一起做。
3.2 缩短稀疏索引与 Engram 访问路径
| 优化 | 原始成本 | 具体改变 |
|---|---|---|
| 稀疏 MQA logits | 全上下文打分后再做Top-K | 仅对候选集打分再做Top-K |
| DeepSelect BF16 Top-k | BF16 分数转 FP32,再选择 | 直接使用 BF16 分数进入 DeepSelect;不满足适用条件时还需要保留原路径 |
| Engram主机内存表的地址映射 | GPU随机访问频繁触发地址转换开销 | ①放在CPU内存,同节点的DP实例共享表。共享表采用 host-NUMA cuMem ②GPU 映射从 64 KB 页转为 2 MB 页,GPU 访问时使用更大的内存页映射,减少随机查表的地址转换开销 |
3.3 Prefill 选择小 DEP,Decode 选择 Wide-EP
Prefill 关注每卡效率与并发请求的进度差。小 DEP 能减少需要协调的 rank 数;当权重与状态已能容纳时,增加实例数量可能比扩大单实例更有效。Decode 的主要机会则是把专家权重分散到更多 GPU,减少每卡专家读取量。
| 优化 | 具体改变 | 效果 |
|---|---|---|
| Prefill 选择 DEP2 | 对比 DEP2、DEP4 的每卡吞吐,并测试请求进度不一致造成的损失 | 指定测试中,DEP2 每卡吞吐为 64.4K,DEP4 为 53.3K tokens/s |
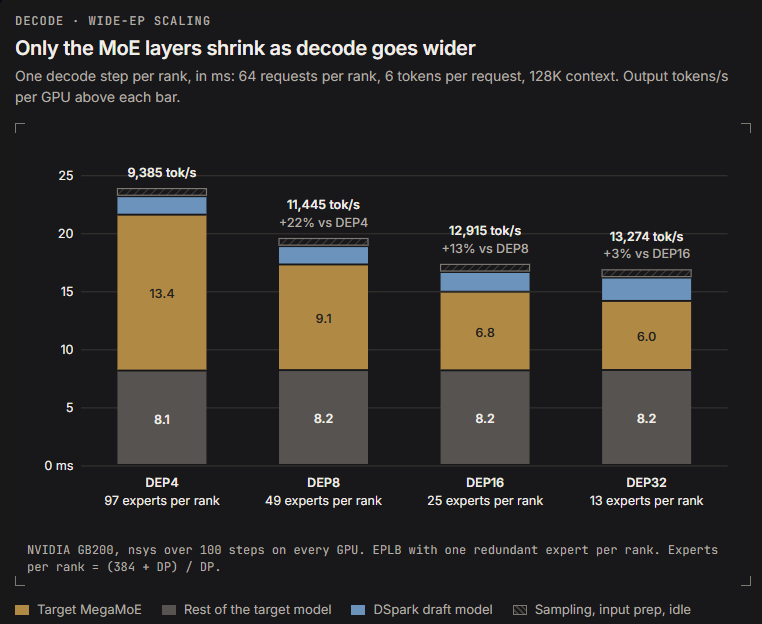
| Decode 扩大 EP 范围 | 将专家权重分散到更多 GPU,并结合 EPLB,从 DEP4 测到 DEP32 | 指定配置下,主模型 MegaMoE 耗时从 13.4 ms 降至 6.0 ms |
3.4 EPLB 同时处理 Target 与 Draft
针对 DS4.1 的 MegaMoE 与 DSpark 改进 EPLB: 加速专家权重迁移,将副本映射及负载统计融合进 MegaMoE,并支持主模型与草稿模型使用不同专家拓扑分别进行负载均衡
| 优化 | 优化目标 |
|---|---|
| 专家迁移、映射融合和异步处理 | 目标是降低 DeepSeek-V4.1-Flash 在多节点 NVLink、DP Attention + MegaMoE 场景下的 EPLB 成本 |
| 主模型与 DSpark 草稿模型分别均衡 | 专门适配 DeepSeek V4.1 的 DSpark,让专家数量、布局不同的 Target 和 Draft 都能参与 EPLB,并正确加载冗余专家权重 |
3.5 把 P/D 传输和 CPU 工作移出 Decode 关键路径
当 GPU 步长变短、rank 数变多,一个 rank 的 CPU 停顿就可能放大让全实例等待。vLLM 围绕以下问题进行优化:
| 存在问题 | 优化方法 |
|---|---|
| Decode 工作线程与提交 KV 读取同步 | NIXL Push,Prefill 完成后,需要把 KV 交给 Decode。如果 Decode 工作线程还要忙着准备、提交大量读取操作,就会影响正在生成的请求。Push 减少了这条线程上的读取提交负担;聚合传输区域则减少零散操作 |
| DP 元数据同步随 rank 增多,同步耗时上升 | 递归倍增 CPU All-reduce,降低同步轮次和大规模协调成本 |
| 某轮集中接入大量新请求 | 限制每步新 KV load 数,将接入成本摊开,避免生成过程突发停顿 |
| 长 Prompt 的接入处理昂贵 | 使用连续 int32 数组传递 Token ID,跳过 SWA 块表中的空条目,并行执行长数组写入,减少请求接入时的数据处理与准备耗时 |
3.6 为小批量建立专用 Decode 路径
低并发不能只复用高吞吐路径:小矩阵算子、元数据构造、同步和启动成本会变得突出。vLLM 使用适合小批量的专用算子,融合通信与相邻计算,并减少元数据准备开销,并优化 DSpark 的草稿层、顺序 Markov 采样循环和 post-forward Graph,缩短完整一轮推测解码的时间
- Markov 采样循环:将原来每个候选位置需要的多个小操作融合,进一步在支持配置下把整条采样链放进协同内核
4 SGLang优化策略
SGLang 集成 FlashMLA、DeepGEMM、DeepEP、DeepSelect 与 Mega 系列。更关注上一个算子的输出能否直接交给下一个算子,进一步优化相邻计算步骤的数据衔接。让 Mega-mHC 的输出直接供 MegaMoE 使用,让注意力直接输出后续投影所需的数据格式,从而减少中间数据读写、格式转换和内核启动开销。
4.1 Engram 提供两种放置方案
Engram 分片放在多张 GPU 显存中。每张 GPU 直接读取持有目标行的 GPU(通过 NVLink 直接读取目标行),减少查表过程中的集合通信开销。
4.2 Bounded replay 与 Breakable CUDA Graph 配合
SGLang 同样利用短尾部重放减少 Prefill 工作。即使大 Prefill 的前段需要 eager 执行,Decoder 尾部仍可使用按短后缀大小捕获的独立 Graph。指定基准在每卡 4K/8K 新 Token 时启用 Breakable Prefill Graph(允许不同部分使用不同的 Graph 或执行方式)。
4.3 冗余专家
指定 Prefill 配置采用 384 个逻辑路由专家 + 32 个冗余副本,即 416 个物理路由专家实例,不包含另行处理的共享专家。EP4 下每卡放置 104 个实例(每卡持有自己的 96 个逻辑专家,并额外复制下一张卡的 8 个专家。)
5 优化情况
5.1 vLLM
- Prefill DEP规模选择:refill DEP2 / DEP4 每卡吞吐分别为64.4K / 53.3K tokens/s。固定 AgentX Prefill 测试中,DEP4 每卡约为 DEP2 的 83%。
两种测试使用相同请求,只改变到达时间:
- mirror(同步到达):各 rank 同时收到相同请求,处理进度比较一致。
- lag(错峰到达):各 rank 收到相同请求的时间依次错开,进度不一致。
layer 20 裁剪 + Engram 主机表地址映射优化 + DeepSelect:在128K 缓存前缀场景,4K–64K 新 Token 吞吐合计提高 35.6%–43.9%(相对该组改动之前的版本,不是相对 DeepInfer)
GB300 NVL72 P/D + Wide-EP:AgentX 每卡 954K tokens/s,P90 用户速度 196 tokens/s,吞吐提升7.9x
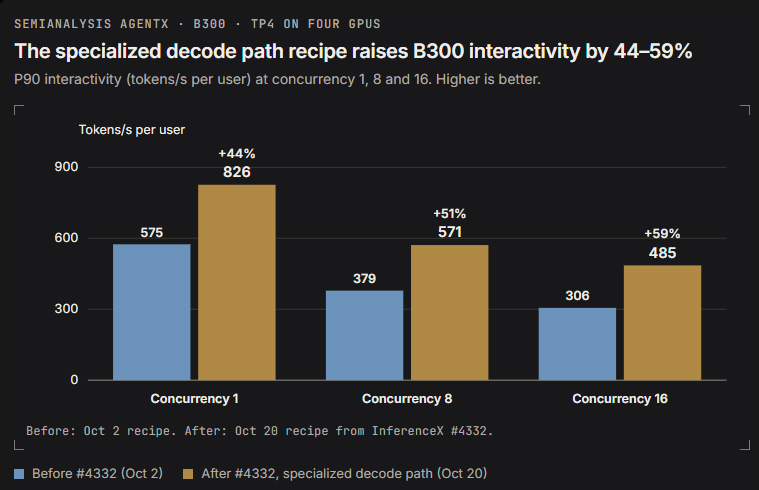
四张 B300 专用小批量 Decode:并发1-16下单用户P90提升44-59%
EPLB:每 3000 步,根据前 1000 步调整专家放置
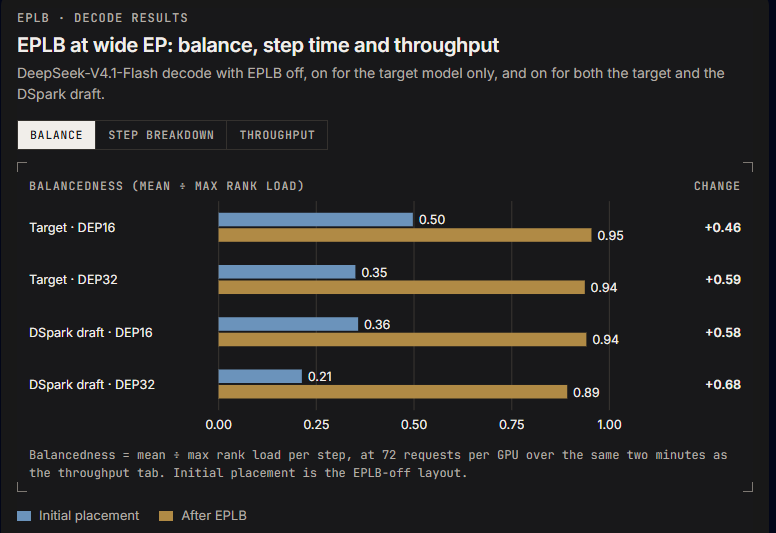
- 均衡度 = 各 rank 的平均负载 ÷ 最忙 rank 的负载,数值越接近1越均衡
- Wide-EP 有效但提升有限:扩大专家并行组,可以加速 MoE,但其他部分没有同比变快,所以继续加 GPU 的收益越来越小
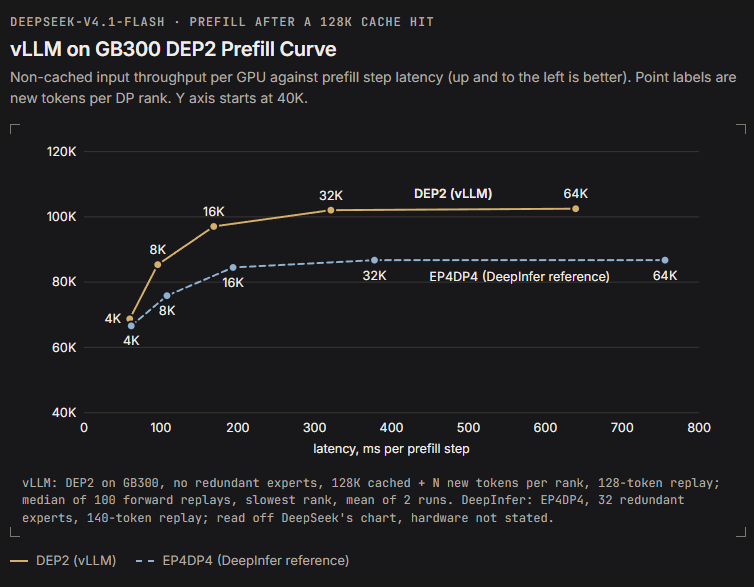
- Prefill
| 配置项 | vLLM | DeepInfer |
|---|---|---|
| 硬件 | GB300 | 未注明 |
| 并行配置 | DEP2,2 张 GPU | EP4DP4,4 张 GPU |
| 缓存前缀 | 128K Token 缓存命中场景 | 未说明 |
| 冗余专家 | 无 | 32 个 |
| Bounded replay 长度 | 128 Token | 140 Token |
| 输入 | vLLM 自己的测试 Prompt | DeepInfer 原始测试输入 |
| 统计方式 | 100 次前向重放取中位数,取最慢 rank,再对两次运行取均值 | 从已发布图表读取 |
- Decode
| 配置项 | vLLM | DeepInfer |
|---|---|---|
| 硬件与并行规模 | 32 张 GB200,DEP32 | EP64DP64,64 张 GPU |
| 每请求上下文 | 约 131K Token | 约 131K Token |
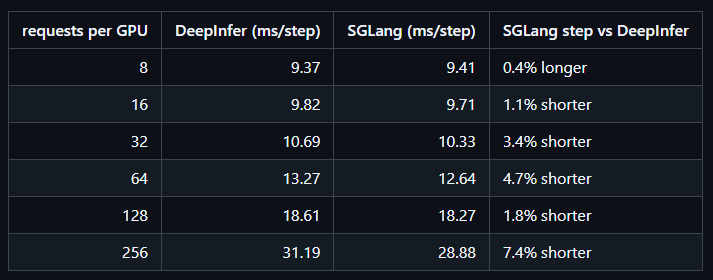
| 每卡批量 | 8、16、32、64、128、256 个请求 | 8、16、32、64、128、256 个请求 |
| 推测解码 | DSpark,每轮 3 个草稿 Token;按平均每步推进 3.25 Token 折算速度 | DSpark,每轮 3 个草稿 Token;按平均每步推进 3.25 Token 折算速度 |
| 专家配置 | 384 个路由专家 + 32 个冗余副本 | 384 个路由专家 + 64 个冗余副本 |
| 路由与均衡 | 真实权重、真实路由,开启 EPLB | 未说明 |
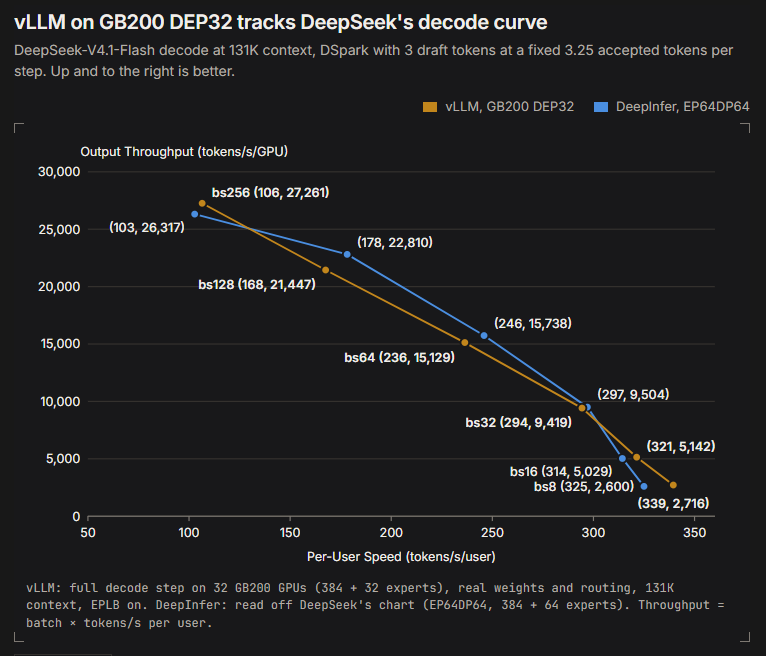
- 二者差距在6%以内
5.2 SGLang
Prefill:
- 单个 GB300 节点的 4 张 GPU,或单台 B300 机器的 4 张 GPU
- DEP4
- 每请求上下文131,072 Token
- 384 个逻辑路由专家 + 32 个冗余副本,共 416 个物理实例,每 GPU 放置 104 个;每卡持有自己的 96 个专家,以及下一张卡的 8 个专家副本
- B 为 4K、8K 时启用 Breakable Prefill CUDA Graph
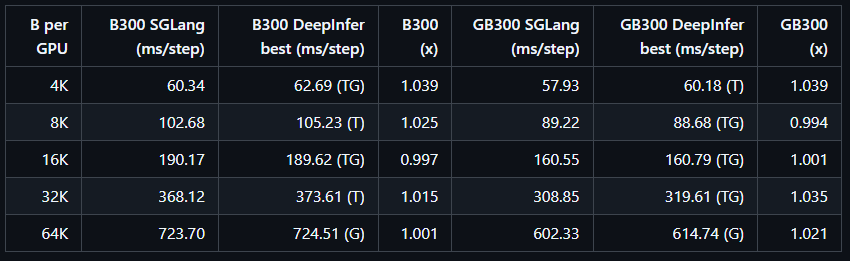
T:Engram 表放在主机内存
G:Engram 表放在 GPU 显存
TG:Engram 表放GPU 显存,同时调整通信参数
Decode:
- 16 个 GB300 节点,每节点 4 张 GPU,共 64 张 GPU,位于同一 NVLink 域;
- DEP64
- 每请求上下文131,072 Token;3 draft tokens;
- 384 个逻辑路由专家 + 64 个冗余副本,共 448 个物理实例,每 GPU 放置 7 个